Core Architecture
四大核心特性:以原创架构重塑推理效能
01 / ARCHITECTURE
DeepSeekMoE 细粒度稀疏激活
通过更小粒度的专家细分与专家特化路由,每次推理仅动态激活必要参数子集,在千亿体量下实现极致计算效率。
02 / ATTENTION
Multi-head Latent Attention (MLA)
采用低秩键值联合压缩技术,大幅降低长序列推理过程中的 KV Cache 显存占用,让 128K 成为高并发常态。
03 / REASONING
纯强化学习长思维链自省
DeepSeek-R1 摆脱对海量人工标注的路径依赖,通过大规模强化学习自发演化出反思、纠错与边界验证能力。
04 / CODE & MATH
工业级代码与数理长逻辑推演
在复杂软件工程重构、跨模块调用调试以及数学定理证明基准上处于全球第一梯队,成为研发生产力利器。
Integration Roadmap
四步递进:从茶席慢读到工业规模化生产
01
网页版零门槛交互体验
访问官方网页版入口,即时感受显式长思维链推演与多轮对话,直观检验大模型在业务边界场景下的逻辑准确度。
02
获取标准 API 访问凭据
在开放平台一键生成高可用 API Key,全面兼容 OpenAI SDK 协议标准,无痛替换现有基座接入点。
03
私有化蒸馏与本地环境部署
借助 Ollama 或 vLLM 部署轻量化权重,实现内网数据不出域的高安全性、低延迟私有化推演集群。
04
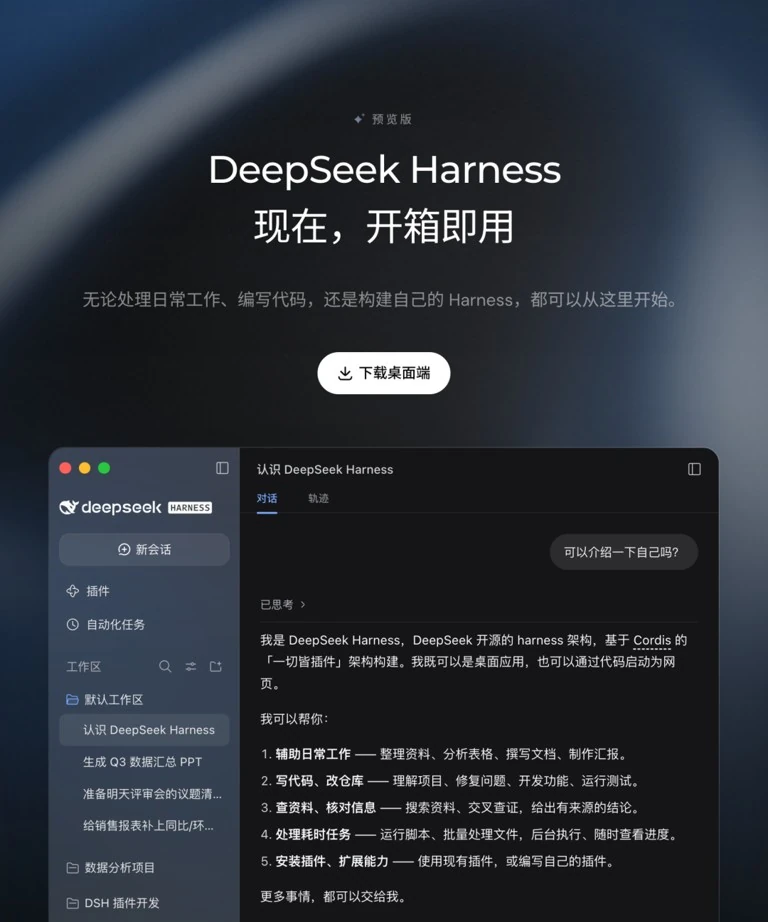
DeepSeek Harness 自动化测试回归
配置 YAML 自动化评估线束,将业务提示词、边界用例纳入自动化 CI 管道,确保生产模型演进零缺陷。
Code Showcase
OpenAI 原生兼容:极客终端快速接入
# 终端安装:pip install openai
from openai import OpenAI
client = OpenAI(
api_key="YOUR_DEEPSEEK_API_KEY",
base_url="https://api.deepseek.com"
)
response = client.chat.completions.create(
model="deepseek-reasoner", # 启用 R1 显式思维链
messages=[
{"role": "system", "content": "你是一位精通拓扑学与形式化证明的系统学者。"},
{"role": "user", "content": "请解析茶席器物隐喻下的 AGI 认知推演边界。"}
],
stream=True
)
for chunk in response:
delta = chunk.choices[0].delta
if hasattr(delta, 'reasoning_content') and delta.reasoning_content:
print(delta.reasoning_content, end="", flush=True)
elif delta.content:
print(delta.content, end="", flush=True)